これまでのAIアバターは、GPUサーバーが前提でした
AIアバターの会話は、これまでクラウドのGPUで音声と映像を作るのが一般的でした。弊社がサービスを展開しているGEMINARIもそのような構成になっていました。
GPUサーバーの費用がかかり、映像と音声を外部へ送る必要があり、通信の往復分の遅れも生じます。
さらに、GPUは同時接続の数に合わせて台数を増やす必要があります。1台で同時2セッションを処理する前提で単純計算で試算すると、同時接続100でT4クラスのGPUが50台、AWSのオンデマンド料金で月19,199ドル(約303万円、バージニア)になります。この費用は、使っていない時間も含めて毎月かかり続けてしまいます。
音声合成とリップシンクが端末で動かせるようになりました
全力機械株式会社は、超軽量で世界一高速(※1)なZEN-LipSync(リップシンクモデル)と世界一高速(※2)なZEN-TTS(音声合成モデル)とを開発し、ユーザーの端末で動作するようにしました。スマートフォンのSafariやChromeで実写のリップシンクが動作し、リアルタイムに対話が可能で、しゃべり終えてから約0.3秒でレスポンスできます。
https://www.youtube.com/watch?v=vVotWg0Yqyw

表1. 各処理の構成
サーバーにはGPUが要りません。音声認識もCPUで動き、4コアの1台で同時50セッション規模を処理できます。
効果1:GPUサーバーの費用がゼロに。CPUサーバーでも動く!

表2. リップシンクモデルの月々の運用価格
一般的なリップシンクモデルは、多様な映像に対応するために大きくなり、GPUサーバーを前提とします。当社は対象動画に特化した超軽量なモデルを開発したため、端末のブラウザでも動かせます。端末の性能に依存しないようにするためにCPUサーバーでリップシンクモデルや音声合成を動かすことも可能です。
端末でモデルを動かす場合はリップシンクや音声合成、音声認識に掛かる費用はゼロ円です、
※ AWSオンデマンド料金、730時間稼働、T4 1台で同時2セッション、1ドル158円で換算。CPU コンテナ:Cloudflare Containers(standard-4、4 vCPU、12GiB)で 4 vCPU あたり同時6セッション、730時間稼働、WebSocket の受信メッセージは20通を1リクエストとして計算(2026年10月20日時点) 。
効果2:通信を待たないので高速
音声合成もリップシンクも端末内で行うことができるため、通信を待たないので高速です。待ち時間を最短にし、リアクションが速くなります。
iPhone(iPhone Air)上で5秒の音声を作るのにわずか約138ミリ秒で、実時間の約36倍の速さです。
音声合成「ZEN-TTS」は商用利用できるニューラル日本語音声合成で、CPU1スレッドの合成速度が世界最速※3です。GPUがない環境でも、Intel XeonのCPU1スレッドで、話す長さの約24倍の速さ(RTF 0.042)で音声を作れます。
計測結果

表3. 日本語ニューラルTTSを同じ条件のCPUで動作させた場合の比較表。RTFは低いほど生成速度が速い。

表4. 同じ条件のCPUで動作させた場合の推論速度比較

表5. ZEN-LipSyncをブラウザのWebGPUで動作させた時の推論速度表
会話は毎秒25フレームで進むため、iPhone Airの値は実時間に対して約5.8倍の余裕があります。
世界初について
スマートフォンのブラウザ内で、音声合成と、音声に同期した実在人物のリップシンクの両方を、端末内でリアルタイムに実行できる実装として、世界初と認識しています(当社調べ、2026年10月15日時点) 。リップシンクも音声合成もどちらもWebGPUで動きます。
ブラウザで実写のリップシンクを動かす先行例はありますが、音声合成は端末内で行っているものはありません。
- DH_live_mini:スマートフォンのブラウザで実写のリップシンクが動きますが、推論はCPUのWASMでWebGPUを使わず 、音声合成はサーバー側です(2024年12月公開) 。
- bitHuman Essence 2:ブラウザのWebGPUで実写のリップシンクを描きますが、スマートフォンには対応せず 、音声合成の処理もサーバー側でオープンなモデルではありません。
デモ
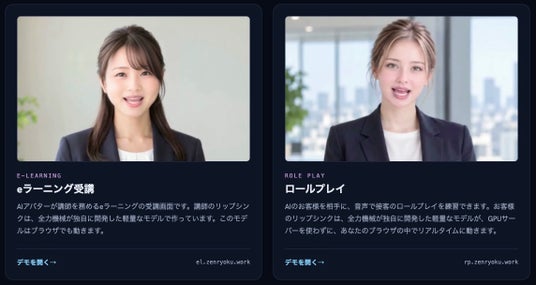
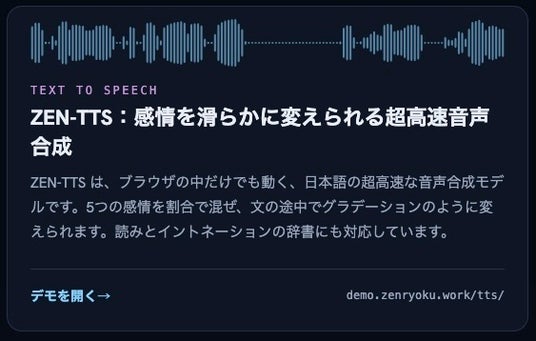
https://demo.zenryoku.work から実際にリアルタイムに動作するデモを試すことができます。PC、スマートフォン(iOS 26以降、Android 17以降)でお試しいただけます。
- eラーニング:AIアバターが講師を務める受講画面のデモです。
- ロールプレイ:AIが演じるお客様との接客練習。会話中、リップシンクがGPUサーバーなしで動くデモです。
- 音声合成デモ:4人の男女の声から選べる音声合成のデモです。感情を配合したり、イントネーションの編集などが可能です。
SDK公開
ZEN-TTS と ZEN-LipSync のモデルとアバター、SDKをあわせて公開しています。
全力機械へのリンクを表示していただければ商用利用も可能です。
SDKを利用することで簡単にリアルタイムの対話システムやリップシンク動画の作成が可能です。
- SDK
https://github.com/zenryokukikai/zen-lipsync
簡単にアバターを利用できるようにするSDKです。
- アバターの配布はこちらhttps://github.com/zenryokukikai/zen-lipsync-avatars
マリン、キッカ、ハシロウの3つのアバターを配布しています。
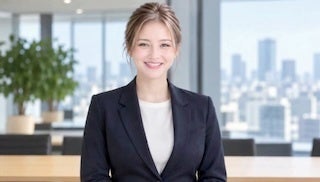
マリン
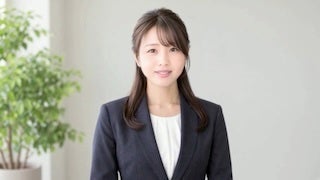
キッカ
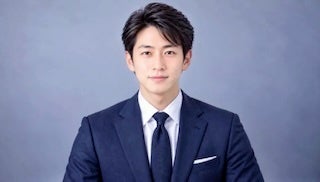
ハシロウ
- TTSモデルの配布はこちら
https://github.com/zenryokukikai/zen-tts
マリン、キッカ、ハシロウ、カイのTTSモデルを配布しています。
会社概要
・社名:全力機械株式会社
・所在地:〒160-0004 東京都新宿区四谷2-8-8 第5三和ビル 802
・代表者:山本 慎也
・設立:2018年11月
・事業内容:人工知能研究開発業務、量子アニーリング事業、ITコンサルティング
・ウェブサイト:https://zenryokukikai.com
本件に関するお問い合わせ
・メール:info@zenryokukikai.com
・窓口:https://demo.zenryoku.work/roleplay/inquiry
注記
- 計測日は2026年10月15日です。金額は1ドル158円で換算しました。スマートフォンとパソコンは、ブラウザのWebGPUで計測しました。
- ※1「リップシンクの世界最速」は2026年10月23日時点、当社調べです。対象は、モデルが公開されていて CPU で動く、音声から実写の唇を動かすリップシンクです。1フレームの推論時間(音声特徴の計算を含む、同じ音声で交互に 4周測った中央値)を比べました。
- - Intel Xeon Silver 4316、CPU のみ・1 スレッド:全力機械 2.85ms(352×160 の範囲)、DH_live_mini 6.13ms(112×80 の口の範囲、描画は除く)。
- - 有料・非公開の製品(bitHuman など)は含みません。これはサーバーの CPU で直接動かした速さです。ブラウザのデモは WebGPU で動きます。
- ※2「ZEN-TTS の世界最速」は2026年10月23日時点、当社調べです。対象は商用利用できる、ニューラルネットワークで声を作る日本語の音声合成です。比べたもの:Supertonic 3、VOICEVOX、Kokoro-82M、AivisSpeech。Piper の日本語の声も測りましたが、声のデータが商用利用不可のため対象外です(ZEN-TTS のほうが速い結果でした)。測定環境:Intel Xeon Silver 4316、CPU のみ・1 スレッド。同じ日本語15文で、文の入力から波形の出力まで(読みの解析を含み、モデルの読み込みは除く)の時間の中央値です。有料・非公開のエンジンは測っていません。
- ※3「世界初」は当社調べです。2026年10月15日時点で、GitHub、arXiv、Hugging Face、npm、主要各社の公式ドキュメントを調査した範囲で、スマートフォンのブラウザ内でWebGPUを用いて、音声合成と音声同期の実在人物リップシンクの両方を端末内でリアルタイムに実行する公開デモは他に見つかっていません。
企業プレスリリース詳細へ
PRTIMESトップへ